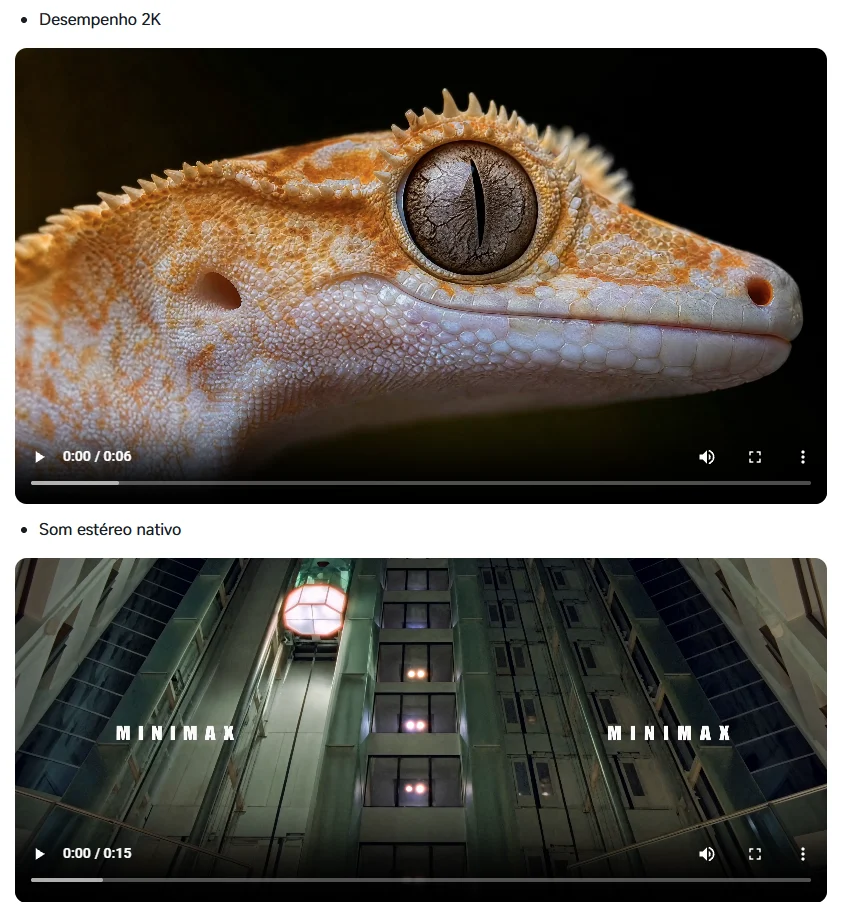
Hoje, estamos lançando o MiniMax H3, um modelo de geração multimodal de uso geral. O H3 compreende o contexto unificado de texto, imagens, vídeo e áudio, gerando vídeos com som estéreo nativo, com duração de até 15 segundos em resolução 2K. Para uma experiência prática rápida, visite https://hailuoai.video/zh-Intl/tools/minimax-h3 .
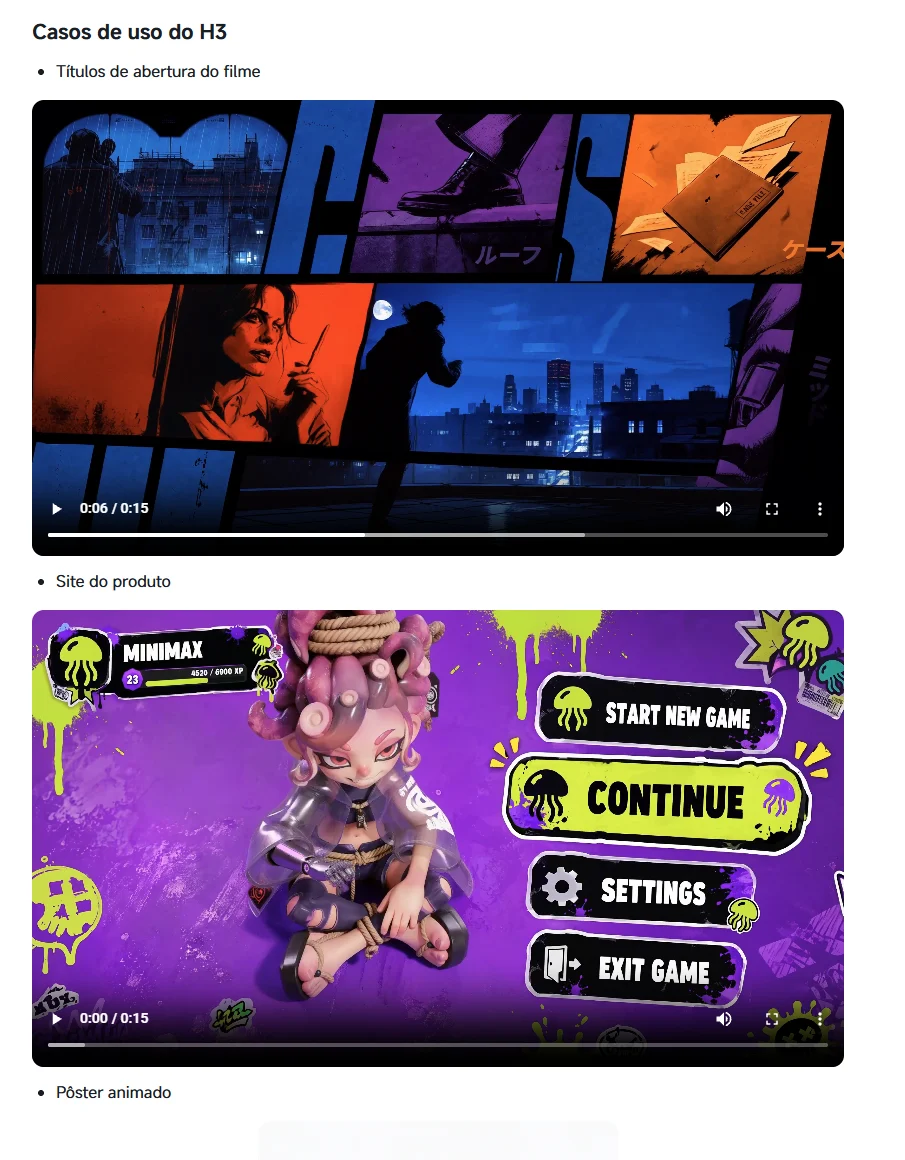
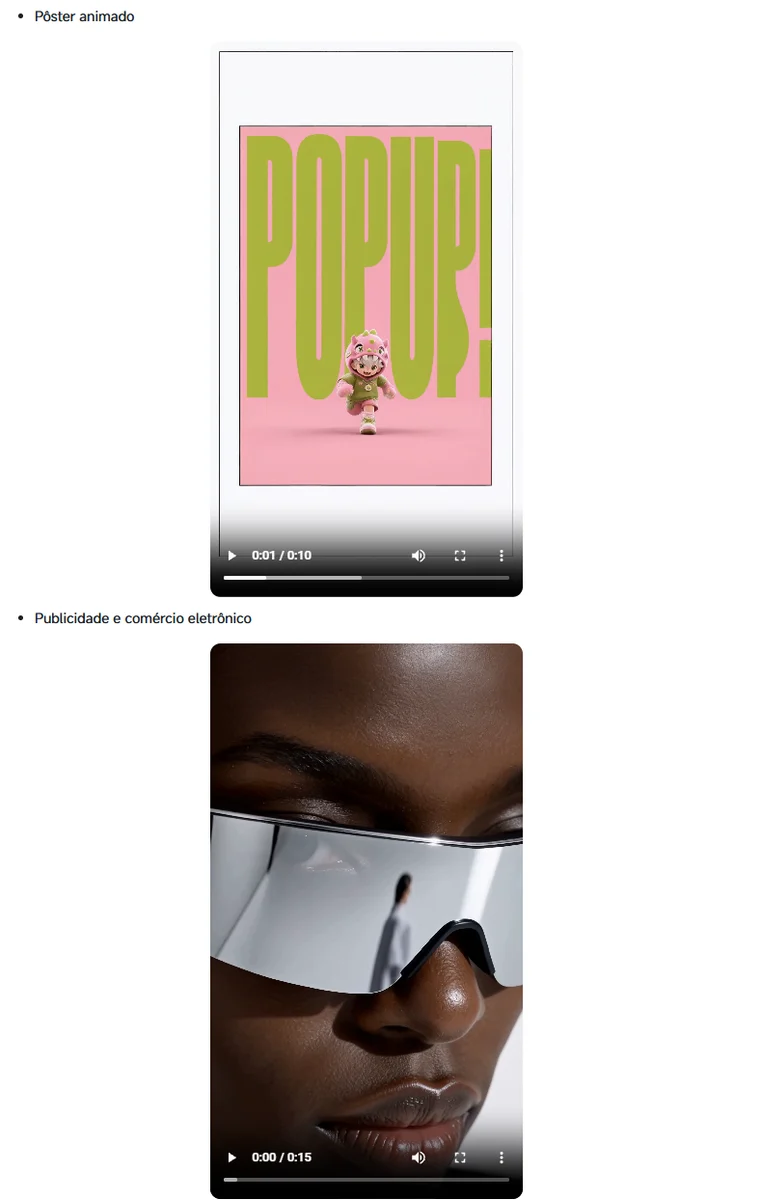
Os testes iniciais mostram que o H3 está pronto para a criação de conteúdo comercial em uma ampla gama de casos de uso, destacando-se no seguimento de instruções, na renderização precisa de texto e marca e na transferência de movimento V2V. Com geração e edição multimodal precisas e controláveis, o H3 foi desenvolvido para publicidade, branding, comércio eletrônico, design de produto, UI/UX, jogos e muito mais.
Com tecnologias como Contextual Omni Representation, H3-VAE, H3-Omni Transformer e In-Context Regeneration, o H3 oferece desempenho com excelente custo-benefício. Oferecemos resolução 2K por padrão. Em 2K, o custo por segundo do H3 é menos de um terço do custo dos modelos convencionais e, em 768p, é menos da metade do preço dos modelos convencionais em 720p.
Os modelos de código fechado têm dominado a geração de vídeo por muito tempo, com iterações mais lentas e um ecossistema menos aberto do que áreas como grandes modelos de linguagem. Para apoiar a comunidade de código aberto, acelerar a compatibilidade com uma gama mais ampla de hardware de IA e facilitar a criação de versões personalizadas pelos usuários, planejamos abrir os pesos do modelo nos próximos dias, sujeitos às leis e regulamentações aplicáveis. A compatibilidade com hardware tem sido uma consideração fundamental desde os estágios iniciais do projeto do H3.
Compreensão do contexto multimodal
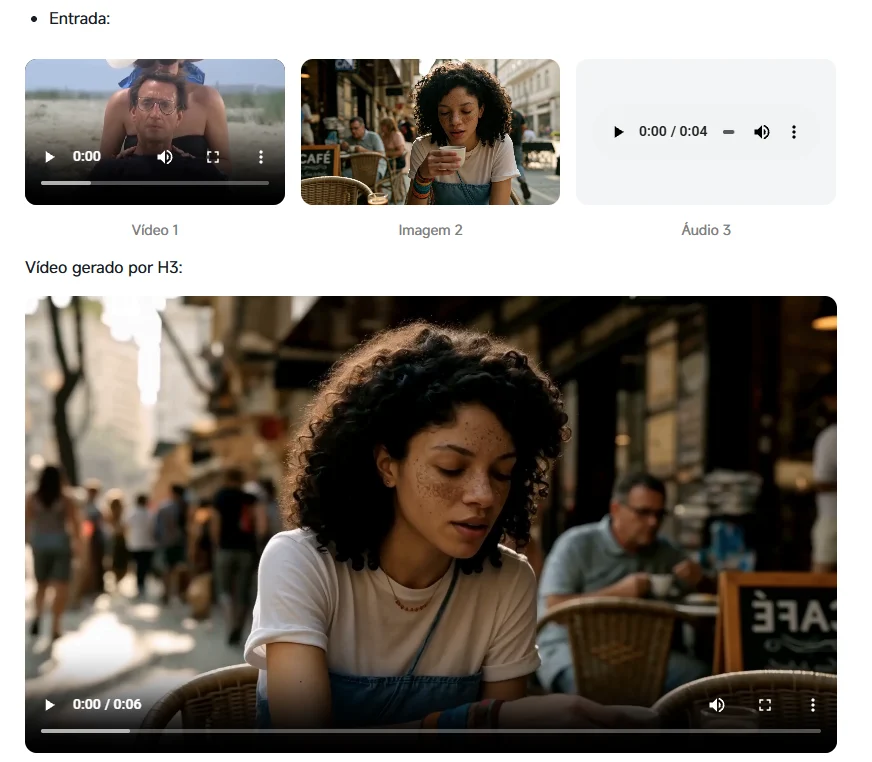
O verdadeiro trabalho criativo exige a combinação de informações complexas entre diferentes modalidades, utilizando imagens, áudio, vídeo e outros elementos como fontes de entrada. Por exemplo, a instrução para a cena abaixo é: “Consulte o movimento de câmera de Hitchcock do Vídeo 1, faça o personagem da Imagem 2 cantar, com a voz correspondendo ao Áudio 3.” Basta descrever a relação entre o contexto e o vídeo em questão com palavras. O H3 lida com essa compreensão complexa e multimodal por conta própria.
Filosofia de Design da H3
Rompendo as barreiras entre tarefas: da especializada à de propósito geral
Anteriormente, desenvolvemos duas gerações de modelos: o Hailuo 01 construiu o sistema do zero, e o Hailuo 02 focou na melhoria de componentes essenciais, como eficiência arquitetônica, qualidade de dados e escalabilidade.
Ao projetar o H3, reconhecemos as limitações dos modelos generativos anteriores em relação aos limites das tarefas: a geração de imagens era tipicamente dividida em modelos especializados separados para T2I, edição, referência de sujeito, referência de movimento e referência de estilo; voz, efeitos sonoros e música na geração de áudio eram amplamente estudados como domínios separados; e a geração de vídeo era ainda mais fragmentada em texto para vídeo, imagem para vídeo, primeiro e último quadro, referência de sujeito, referência de movimento, referência de voz, edição de vídeo e muito mais, com limites claros também entre imagem, vídeo e áudio.
Essas tarefas, capacidades e modalidades isoladas restringiam a liberdade criativa na prática. E, no que diz respeito ao treinamento, limitavam a capacidade de generalização do modelo. Ambos os fatores apontam para uma grande margem de mudança, tanto no paradigma de aplicação quanto no paradigma de treinamento. Portanto, o primeiro princípio que norteou o desenvolvimento do H3 foi a unificação e a generalização entre as tarefas.
Com base nisso, segue uma breve descrição do paradigma de pré-treinamento do H3:
- Dados e Tarefas
- Texto para imagem
- Texto para vídeo
- Com áudio gerado em conjunto, toda a saída de áudio é estéreo nativa.
- Modelagem nativa de múltiplas fotos
- Texto para áudio
- Sem separação entre voz, efeitos sonoros e música — tudo modelado em conjunto.
- Referência e edição generalizadas
- Referência e edição de imagem para imagem
- Referência e edição de imagem para vídeo
- Referência e edição de áudio para áudio
- Referência e edição de áudio-vídeo para áudio-vídeo
- Em nosso projeto, “referência e edição generalizadas” significa:
- Construído inteiramente a partir de dados reais e naturais, o que lhe confere uma forte escalabilidade de dados.
- As relações de referência e edição são expressas por meio da linguagem natural, em vez de se restringirem a um conjunto fixo de tarefas; a linguagem (ou a estrutura da inteligência, em termos gerais) é a ponte para a generalização.
- Arquitetura
- Incorpore diferentes tipos de dados e tarefas o mais cedo possível — a proporção ideal é fundamental.
- Estratégia de treinamento
- Combine diferentes tipos de dados e tarefas o mais cedo possível no treinamento — a proporção correta dessa combinação é fundamental.
Todas essas escolhas apontam para o mesmo objetivo: dar ao H3 amplas capacidades de compreensão e geração de contexto multimodal desde o estágio de pré-treinamento.
Anteriormente, falamos sobre a mudança no paradigma de treinamento, então como o cenário de aplicação para modelos de vídeo também está mudando?
Estamos vendo criadores descreverem suas intenções diretamente em linguagem natural, em vez de apenas inserir um simples comando visual. À medida que a compreensão multimodal, o seguimento de instruções e a execução de tarefas complexas continuam a melhorar, os modelos de vídeo serão capazes de captar a intenção criativa de forma mais completa, lidar com necessidades de conteúdo mais complexas e, gradualmente, passar de “gerar um clipe” para participar genuinamente de todo o processo de produção de conteúdo.
Escolhas técnicas do H3
O H3 foi construído com base em uma filosofia de design simples, mas dar vida a ele foi extraordinariamente complexo. Do Hailuo 01 e Hailuo 02 ao H3, cada geração foi uma ordem de magnitude mais complexa de construir do que a anterior.
Uma breve análise de algumas das principais tecnologias da H3:
- Representação Omni Contextual H3
Uma das coisas mais importantes que fizemos no desenvolvimento do H3 foi aprimorar sua capacidade de legendagem.
- A introdução do contexto multimodal ampliou ainda mais o escopo da “legenda”; não estamos mais descrevendo apenas o vídeo em si, mas também a relação entre o contexto e o vídeo, e até mesmo as relações entre os elementos dentro do próprio contexto.
- Precisamos descrever vídeo e áudio em conjunto, e essa relação audiovisual torna-se ainda mais complexa em múltiplas tomadas.
- Fundamentalmente, trata-se de uma forma de Representação Contextual Omni, onde a linguagem atua como ponte e intérprete generalizável, unificando “tarefas” em uma forma aberta e descritiva. Essa é a raiz da ampla capacidade de seguir instruções do H3.
- Para chegar lá, construímos modelos dedicados e um pipeline de compreensão de modalidade completa. A maior parte do material de origem requer cerca de 100 mil tokens de inferência, destilados para uma média de aproximadamente 4 mil tokens.
- H3-VAE: Um grande impulso na eficiência arquitetônica
- A série H tem continuamente impulsionado o avanço da tecnologia de tokenização. Com o H3, reformulamos completamente nosso tokenizador anterior, alcançando ganhos abrangentes em qualidade de reconstrução e capacidade de aprendizado, o que confere ao H3 uma vantagem competitiva em eficiência. Sua alta taxa de compressão também proporciona um ganho de 4 vezes no comprimento efetivo da sequência, reduzindo substancialmente os custos de treinamento e inferência, e é a tecnologia chave por trás do nosso suporte nativo à resolução 2K.
- Transformador H3-Omni
Transformador H3-Omni: Uma arquitetura construída para generalização de tarefas
- Em consonância com a filosofia de projeto da H3, que prega que “a arquitetura deve servir à tarefa”, generalidade e eficiência foram os únicos dois objetivos. Notavelmente, descartamos a arquitetura Hailuo-02, apesar das significativas vantagens arquitetônicas que ela nos proporcionou, porque introduziria complexidade desnecessária para um modelo construído em torno da generalização de tarefas. Acreditamos que a generalização de tarefas é uma tendência irreversível e que os artifícios arquitetônicos devem ceder espaço à definição do modelo.
- Na H3, a introdução do contexto multimodal triplicou a variância no comprimento da sequência, e as cargas de trabalho computacionais para compreensão e geração tornaram-se consideravelmente mais heterogêneas. Adotamos uma arquitetura de treinamento que separa as cargas de trabalho de compreensão e geração, ajustando a utilização do hardware para cada uma, enquanto equilibramos conjuntamente a computação heterogênea por amostra com o balanceamento de carga entre as amostras. De ponta a ponta, isso aumentou a taxa de transferência do treinamento em quase 30%.
- Regeneração H3 em contexto
- Para a saída 2K do H3, em vez de usar um módulo de super-resolução dedicado convencional, fazemos com que o modelo base do H3 regenere sua própria saída de baixa resolução no contexto. Isso traz duas vantagens: primeiro, o processo de regeneração reutiliza ao máximo a capacidade generativa já integrada ao modelo base do H3; segundo, a abordagem no contexto permite que ele utilize novamente o contexto multimodal original para produzir uma saída de alta resolução, recuperando detalhes que a super-resolução tradicional só consegue “adivinhar” e muitas vezes não consegue restaurar, como textos pequenos e detalhes finos.
Em breve, compartilharemos o relatório técnico completo do H3. Aguardamos seu feedback.
Nossa visão e o que vem a seguir
A linguagem, as imagens, o vídeo e o áudio são modalidades fundamentais da experiência humana. Estão profundamente interligadas e servem como nossas principais interfaces com o mundo. Juntas, formam contextos multimodais que podem comunicar uma vasta gama de informações de forma eficiente, e a capacidade de expressar e compartilhar informações é, em si, uma forma de produtividade .
Para a compreensão e geração multimodal, consideramos a linguagem como um sistema computacional generalizável e escalável. É por isso que acreditamos que a inteligência multimodal deve estar profundamente fundamentada na linguagem.
O H3 ainda tem espaço para crescer, e aqui estão nossas prioridades para versões futuras:
- Uma sólida compreensão multimodal é a base para a geração de alta qualidade, e há um espaço significativo para melhorias. Na próxima geração da série H, planejamos integrar recursos dos nossos modelos da série M.
- O tamanho atual do modelo do H3 permite melhorias em diversas funcionalidades. A escalabilidade é um caminho claro a seguir, e acreditamos que uma generalização de tarefas mais robusta nos permitirá explorar todo o seu potencial.
- Em certos cenários, ainda é possível aprimorar os detalhes visuais. Continuaremos buscando resoluções mais altas e maior fidelidade visual.