Hoje, apresentamos o MiniMax Music 3.0, nosso modelo de geração musical de última geração. A partir de um conceito criativo e letras opcionais, o modelo compõe, arranja, executa e produz uma música completa em uma única geração.
Music 3.0 concentra-se nos aspectos da criação musical mais difíceis de capturar com um simples estímulo: compreender a intenção expressiva do criador; sustentar essa intenção ao longo de uma música completa de até cinco minutos; reproduzir instrumentos com clareza e realismo físico; e gerar vocais que soem como se fossem executados ao vivo, em vez de sintetizados.
Para alcançar esse objetivo, redesenhamos todo o pipeline de geração — da descrição musical e modelagem da linguagem à renderização de áudio. Descrições temporais detalhadas capturam a evolução da emoção, da instrumentação e da interpretação vocal. Um modelo híbrido de linguagem (Hybrid-LM) global-local modela conjuntamente a estrutura de longo alcance e os detalhes acústicos. A quantização vetorial residual (RVQ) multicamadas, a fusão de estados ocultos, a correspondência de fluxo e um algoritmo de expressão variável de fluxo (Flow-VAE) aprimoram ainda mais a fidelidade da saída. Juntos, esses avanços proporcionam três grandes melhorias: interpretação mais precisa da intenção criativa, arranjos mais completos e variados e um som mais claro e natural.
Música 3.0: Arquitetura Técnica
O Music 3.0 compreende três componentes principais interligados: o tokenizador, o Hybrid-LM e a pilha de síntese. Eles abordam, respectivamente, como a informação musical é representada, como a estrutura de longo alcance e os detalhes locais são modelados e como o áudio é reconstruído com alta fidelidade. O fluxo de trabalho completo é mostrado abaixo.
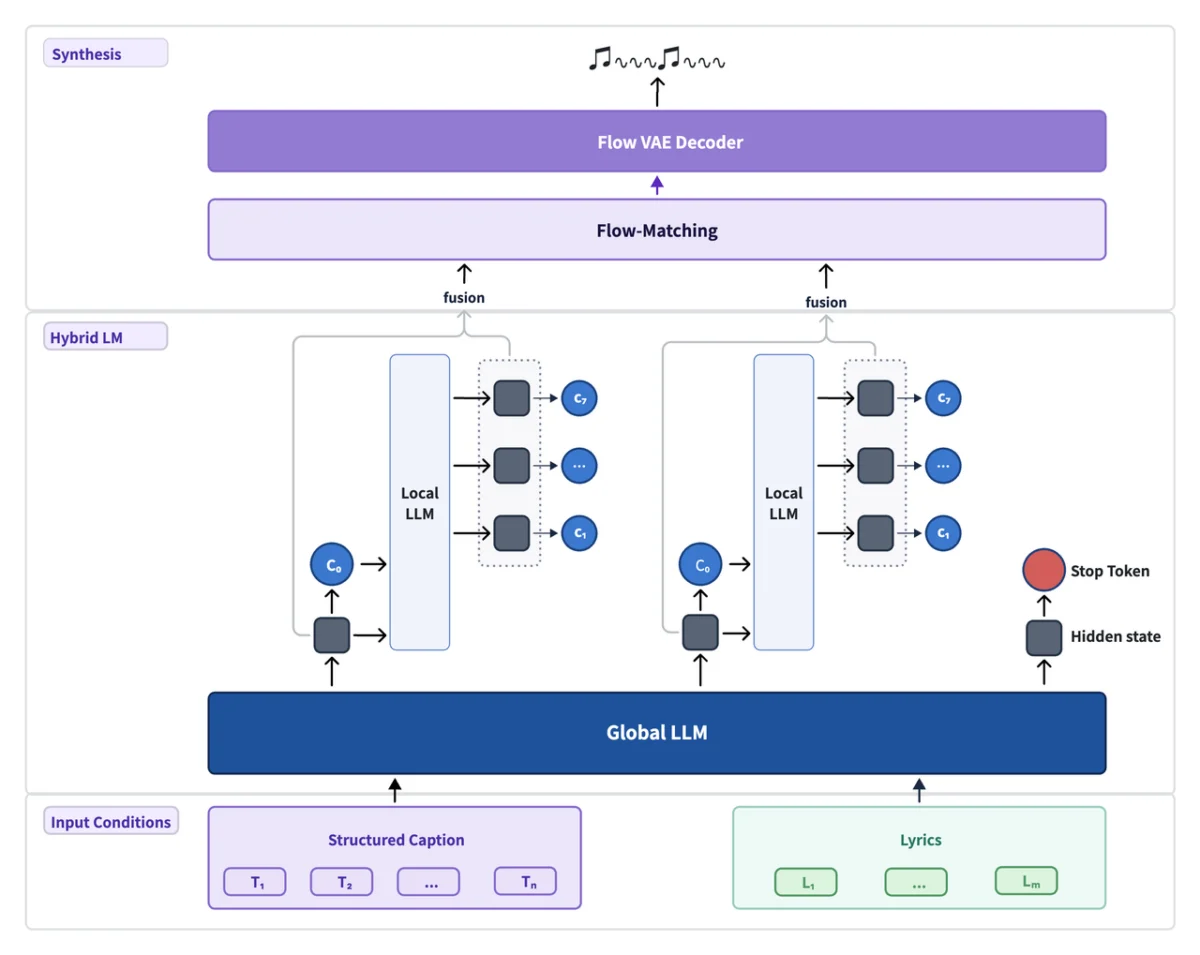
RVQ Multicamadas: Separando a Estrutura Central dos Detalhes Acústicos
Um RVQ de oito camadas representa informações musicais hierarquicamente. A primeira camada captura a semântica e a estrutura essenciais, enquanto as sete restantes codificam progressivamente os resíduos acústicos. No treinamento em etapas, a primeira camada aprende inicialmente uma base de informações estável; todos os dicionários de códigos são então treinados conjuntamente para modelar o som em detalhes. Esse design proporciona uma representação discreta mais estável para a predição de sequências longas e evita sobrecarregar uma única camada de tokens com informações estruturais e relacionadas à fidelidade.
Hybrid-LM: Modelagem conjunta da estrutura global e da acústica local
O modelo LLM Global de 8 bits é inicializado a partir do Qwen3.5-8B e realiza a predição de tokens semânticos quadro a quadro, enquanto modela o contexto global. Um modelo LLM Local de 0,6 bits, inicializado aleatoriamente, prediz tokens acústicos dentro de cada quadro ao longo do eixo de profundidade. O treinamento ocorre em duas etapas: primeiro, o alinhamento global estabelece a capacidade do modelo LLM Global de predizer a semântica musical, seguido pelo treinamento conjunto completo dos parâmetros dos modelos global e local. Essa colaboração hierárquica permite que o modelo preserve a estabilidade estrutural da música, ao mesmo tempo que resolve os detalhes acústicos dentro de cada quadro.
Fusão de estados ocultos: da predição discreta à renderização contínua de áudio
Os sistemas convencionais normalmente enviam tokens acústicos discretos diretamente para um decodificador. O Music 3.0, por sua vez, funde estados ocultos contínuos do LLM Global e do LLM Local e os utiliza para condicionar um módulo de correspondência de fluxo de 2,4 bits. Um Flow-VAE de 123M então decodifica o áudio. O caminho completo é:
Funcionalidades LLM fundidas → Correspondência de fluxo → Estados ocultos VAE → Decodificador Flow-VAE → Áudio final
Este projeto conecta diretamente a compreensão estrutural do modelo de linguagem com a reconstrução de áudio do modelo acústico por meio de representações contínuas. Ele preserva a consistência a longo prazo, ao mesmo tempo que melhora a precisão da pronúncia, a coerência instrumental e a fidelidade dos detalhes.
Entendendo a Intenção Criativa
A música gerada por IA pode soar como uma canção completa e ainda assim se distanciar do conceito original. Instrumentos específicos podem desaparecer gradualmente do arranjo, o caráter emocional pretendido pode enfraquecer à medida que a música se desenvolve, e um estilo vocal solicitado pode aparecer em apenas uma seção, em vez de permanecer coerente ao longo de toda a peça.
O Music 3.0 introduz uma estrutura de descrição musical mais expressiva. Em vez de resumir uma peça inteira com um único rótulo global, ele usa Legendas Estruturadas para descrever a música com alta granularidade temporal. Essas legendas especificam gênero, andamento, compasso, tonalidade, uso e características da produção, além de acompanhar o contorno emocional; a entrada e saída dos instrumentos principais e de apoio; o desenvolvimento do ritmo e da energia dos graves; e as mudanças em nível de seção na interpretação vocal, harmonia e efeitos vocais.
Essas descrições convertem impressões subjetivas de audição em uma estrutura de arranjo profissional que o modelo pode aprender e executar. Como resultado, o modelo consegue traduzir a linguagem criativa em expressão musical concreta com mais precisão, manter uma identidade musical coerente à medida que a música se desenvolve e ainda introduzir a variação dinâmica necessária.
Para tornar a criação musical profissional mais acessível, também desenvolvemos um Sistema de Aprimoramento de Instruções baseado em modelos. Ele seleciona a linguagem apropriada de uma biblioteca de modelos de Legendas Estruturadas e aplica terminologia musical e princípios de arranjo estabelecidos para expandir uma descrição simples do usuário em uma instrução detalhada e musicalmente coerente. Os criadores podem, portanto, exercer controle preciso sem dominar vocabulário especializado — seja para uma performance acústica intimista e contida; uma faixa de R&B noturna impulsionada por hi-hats pulsantes e graves profundos de 808; ou uma música instrumental cinematográfica que cresce da introspecção à intensidade em grande escala.
Arranjos mais completos e variados
O desafio de compor músicas de longa duração não é apenas criar algo com uma duração maior; é criar uma progressão coerente entre as seções. A emoção precisa se desenvolver e se resolver, os instrumentos precisam entrar, se sobrepor e recuar nos momentos certos, e versos, refrões, pontes e passagens instrumentais precisam servir a uma direção unificada.
O Music 3.0 aborda esse desafio em dois níveis. Primeiro, as etiquetas de seção nas letras — como [intro], [verso], [pré-refrão], [refrão], [ponte], [instrumental], [solo] e [final] — definem a macroestrutura da música. Segundo, a Legenda Estruturada especifica o desenvolvimento emocional, as mudanças de instrumentação, a interpretação vocal, a base rítmica, os timbres ornamentais e os efeitos espaciais em cada etapa, transformando o que muda e onde muda em uma condição explícita de geração.
Em termos de modelagem, o Music 3.0 utiliza um modelo híbrido colaborativo global-local (Hybrid-LM). O modelo global de linguagem (8B Global LLM) prevê os principais elementos semânticos e estruturais quadro a quadro, mantendo o contexto completo da música. O modelo local de linguagem (0.6B Local LLM) prevê elementos acústicos ao longo do eixo de profundidade em cada quadro, fornecendo detalhes sonoros locais. Essa divisão de responsabilidades mantém a estabilidade temporal em músicas de até cinco minutos, preservando a rica variação dentro de cada seção.
Aprimorando a qualidade do áudio
Uma composição envolvente exige um som igualmente convincente. O Music 3.0 proporciona uma melhoria substancial na qualidade de áudio, produzindo mixagens mais abertas, claras e equilibradas, com menos congestionamento e distorção.
A modelagem de áudio começa com a quantização vetorial residual (RVQ) multicamadas. A primeira camada utiliza um dicionário de códigos com 16.384 entradas dedicado à semântica e estrutura essenciais da música. As camadas 2 a 8 utilizam, cada uma, um dicionário de códigos com 1.024 entradas e codificam progressivamente os detalhes acústicos residuais. Durante o treinamento, primeiro treinamos a camada inicial de forma independente para que ela capture as informações essenciais da maneira mais abrangente possível; em seguida, todas as oito camadas são treinadas em conjunto. Esse design hierárquico equilibra a capacidade semântica, a estabilidade da geração e a reconstrução de detalhes, ao mesmo tempo que reduz o acúmulo de erros na geração de sequências longas.
A renderização de áudio final do Music 3.0, no entanto, vai além de tokens discretos. No momento da inferência, a pilha de síntese não carrega o caminho de decodificação do tokenizador discreto. Em vez disso, ela funde estados ocultos contínuos das camadas finais do LLM Global de 8 bits e do LLM Local de 0,6 bits, e então gera áudio diretamente por meio de correspondência de fluxo e do Flow-VAE. Comparadas apenas com tokens discretos, essas características contínuas retêm informações acústicas multidimensionais mais ricas, melhorando a precisão da pronúncia vocal e a coerência física do som instrumental.
O módulo de correspondência de fluxo 2.4B mapeia as características do modelo de linguagem fundidas no espaço latente do VAE. O Flow-VAE 123M herda a arquitetura MiniMax Speech e é retreinado para faixas dinâmicas e distribuições espectrais específicas da música, a fim de reconstruir a forma de onda final. Isso permite que o modelo siga direções instrumentais mais precisas e reproduza técnicas de performance autênticas, como glissando e legato. Os papéis instrumentais ficam mais distintos dentro do arranjo, os graves mantêm o impacto sem mascarar a mixagem e os detalhes sonoros sutis permanecem nítidos mesmo em produções com muitas camadas.
Essas melhorias abrangem toda a gama da expressão musical: o ataque das cordas e o arco em instrumentos solo, o impacto da bateria e do baixo, a separação de fontes em arranjos eletrônicos complexos e a sensação de espaço ao redor da voz. O Music 3.0 aproxima cada um desses elementos da experiência de audição de uma gravação totalmente produzida.
Vocais mais naturais
É frequentemente na voz que o caráter sintético da música gerada por computador se torna mais evidente. Artefatos de alta frequência, fraseado rígido, pronúncia pouco clara e respiração artificial podem quebrar a conexão emocional do ouvinte, mesmo quando a música, de resto, é extremamente bem produzida.
O Music 3.0 introduz um novo sistema de renderização de áudio projetado para produzir performances vocais mais naturais e com qualidade de estúdio. A Legenda Estruturada descreve em detalhes o timbre vocal, a entonação, técnicas como respiração e falsete, arranjo harmônico e efeitos como delay e Auto-Tune. Estados ocultos contínuos, fundidos a partir dos modelos de linguagem global e local, carregam essas informações de performance para o processo de correspondência de fluxo e geração de Flow-VAE. Juntos, esses mecanismos reduzem os artefatos digitais de alta frequência comuns em vocais gerados, ao mesmo tempo que aprimoram o controle sobre melodia, pronúncia, respiração e harmonias em camadas.
As vozes podem responder de forma mais coerente às mudanças de emoção e ritmo — passando de versos contidos para refrões expansivos, ou de uma execução rítmica precisa para linhas melódicas sustentadas e abertas. As harmonias se desenvolvem de forma mais natural ao redor da voz principal, e a respiração torna-se parte da performance, em vez de um artifício sintético sobreposto a ela.
Desde a intenção criativa e a estrutura da música até os detalhes acústicos locais e a renderização final do áudio, o Music 3.0 eleva a geração musical da produção de áudio plausível à realização de uma visão criativa completa e coerente.