O MiniMax M3 foi lançado oficialmente hoje.
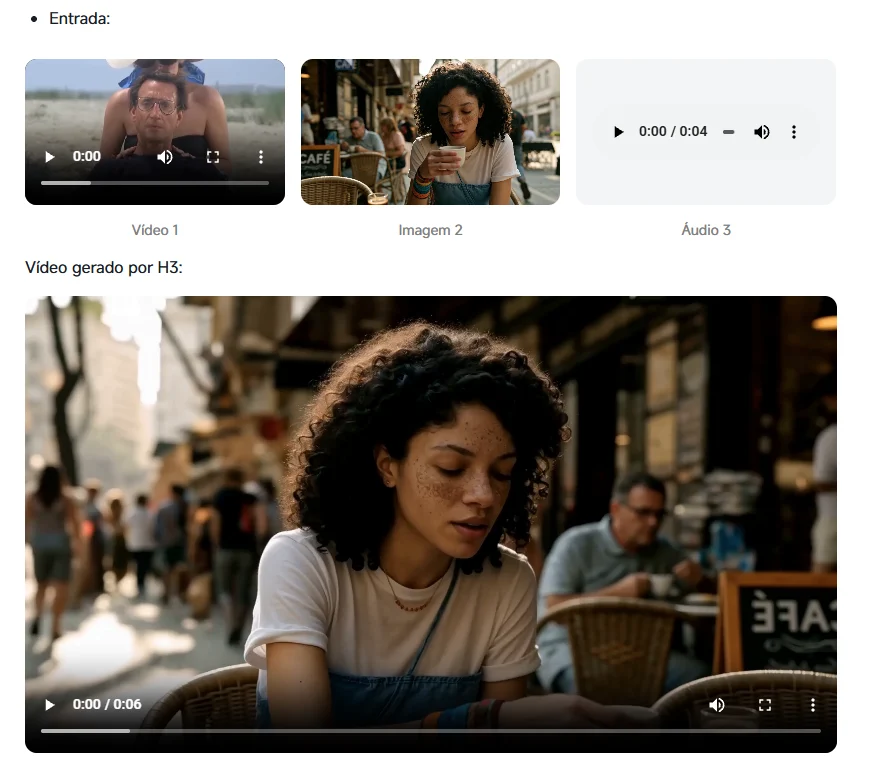
O M3 atinge desempenho de ponta em tarefas especializadas, como codificação e trabalho com agentes. Ele utiliza MSA (MiniMax Sparse Attention), uma nova arquitetura de atenção proposta por nossa equipe, e suporta janelas de contexto ultralongas de até 1 milhão de tokens. Para grande expectativa, trata-se também de um modelo nativamente multimodal que suporta entrada de imagem e vídeo e pode ser executado em um computador desktop.
Essas três capacidades são agora requisitos básicos para modelos de ponta de código fechado. O M3 é atualmente o primeiro e único modelo de peso aberto a reunir todas as três.
Em termos de recursos de codificação, o M3 apresenta melhorias significativas em relação ao M2, aproximando-se do nível dos principais modelos proprietários internacionais em áreas como correção de bugs, desenvolvimento de front-end/back-end e otimização de desempenho.
Em termos de capacidades de agência, o M3 apresenta um desempenho sólido em fluxos de trabalho de escritório comuns, como pesquisa e tarefas do pacote Office, e também se mostrou inicialmente utilizável no domínio financeiro.
Você pode experimentar o MiniMax M3 imediatamente através do MiniMax Code, do Plano de Tokens e dos nossos serviços de API.
MSA: Inovação arquitetônica possibilita a escalabilidade contextual
Resolver tarefas mais complexas para o Agente era um dos objetivos mais importantes no treinamento do M3, e um dos maiores desafios envolvidos era o escalonamento contextual. Para alcançar uma mudança real, é preciso começar no nível mais fundamental — o mecanismo de atenção — e evitar a “falha inerente” da atenção plena: o crescimento quadrático da complexidade computacional.
MSA é uma nova arquitetura de atenção esparsa, limpa e facilmente extensível. Ela oferece ao M3 uma janela de contexto de 1 milhão e transforma o contexto em uma dimensão verdadeiramente escalável.
Os mecanismos de atenção esparsa geralmente evitam o problema da explosão de complexidade adicionando um estágio de pré-filtragem. Comparado com abordagens como DSA e MoBA, o MSA consegue particionar o KV em blocos com mais precisão, alcançando uma cobertura contextual efetiva maior.
Ao mesmo tempo, também otimizamos diretamente no nível do operador, adotando uma abordagem de “agregação externa KV Q” que usa blocos KV como o loop externo para agregar as consultas que os atingem. Cada bloco é lido apenas uma vez e o acesso à memória é contíguo; sob a configuração de cabeçalho do M3, a intensidade aritmética é significativamente melhor do que os métodos comuns — mais de 4 vezes mais rápida do que o Flash-Sparse-Attention e o flash-moba de código aberto.
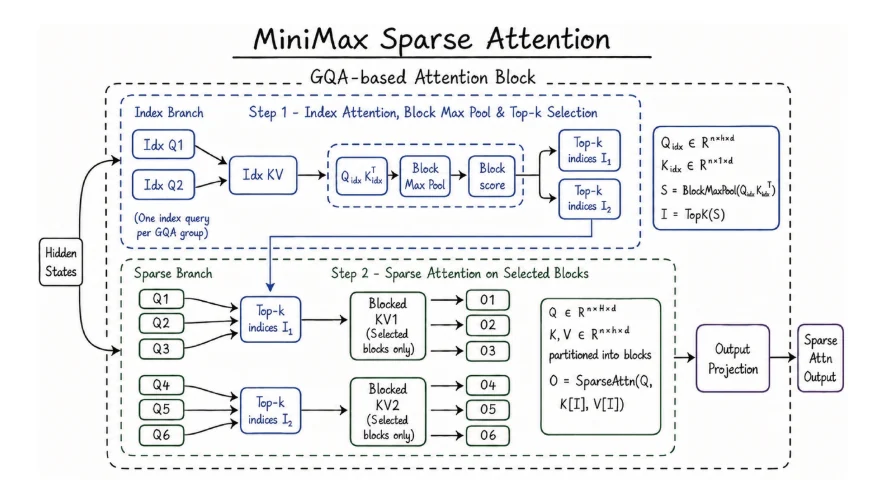
Suas características de limpeza, escalabilidade, facilidade de implementação e compatibilidade com hardware permitem que seus ganhos teóricos sejam plenamente realizados na prática: com um comprimento de contexto de 1 milhão, o custo computacional por token do M3 é apenas 1/20 do modelo da geração anterior. Obtivemos uma aceleração de mais de 9 vezes na etapa de pré-preenchimento e mais de 15 vezes na etapa de decodificação. Além disso, em múltiplas ablações, o MSA apresentou desempenho equivalente à atenção completa na grande maioria das capacidades.
Codificação de Fronteira e Capacidades Agenciais
As capacidades de codificação e de interação com agentes são áreas-chave de melhoria para o M3. Em benchmarks internacionalmente reconhecidos que abrangem engenharia de software e execução em terminais, o M3 alcança a vanguarda:
- SWE-Bench Pro: 59,0%
- Bancada de terminais 2.1: 66,0%
- Eficiência SWE: 34,8%
- KernelBench Difícil: 28,8%
- Atlas MCP: 74,2%
Hoje em dia, a proficiência em programação depende cada vez mais da capacidade de treinar modelos usando a lógica do usuário no mundo real. Os benchmarks de programação existentes muitas vezes não conseguem capturar completamente a experiência real do usuário.
A maioria dos treinamentos e avaliações atuais de agentes de código se baseia na premissa de tarefas de turno único. Mas o uso no mundo real não é assim. Os usuários frequentemente colaboram continuamente na mesma sessão: esclarecendo requisitos, ajustando soluções, atribuindo tarefas em diferentes contextos e iterando em várias rodadas com base em resultados intermediários.
Para reduzir a discrepância entre os parâmetros de referência e a experiência real do usuário, criamos uma estrutura de simulação de usuário interativa.
Ao simular os padrões de comportamento de desenvolvedores reais durante a colaboração, a estrutura expõe os modelos, tanto durante o treinamento quanto na avaliação, a cenários de interação muito mais próximos dos ambientes de produção. Ela pode simular comportamentos como elaboração de requisitos, discussão de soluções, correção baseada em feedback, alternância contínua de tarefas e iteração complexa de projetos. Como resultado, o agente não apenas executa instruções passivamente, mas pode colaborar ativamente com os usuários para concluir tarefas.
A próxima geração de programação robótica não será medida apenas pela geração de código, mas também pela capacidade de colaboração a longo prazo, pela habilidade de planejamento e pela eficiência da colaboração entre humanos e agentes. O M3 amplia os dados que realmente importam para a programação e os agentes, com o objetivo não só de liderar em benchmarks, mas também de se tornar um parceiro colaborativo confiável para desenvolvedores em fluxos de trabalho de P&D do mundo real.
Multimodalidade: Treinamento Intercalado, Escalonamento Contínuo
M3 é um modelo que passou por treinamento multimodal desde a Etapa 0. Essa abordagem multimodal nativa permite que os espaços semânticos de diferentes modalidades se fundam de forma mais natural e profunda.
Entretanto, nossos extensos experimentos mostram que dados intercalados escalam mais facilmente do que dados sintéticos. Como resultado, durante o ciclo M3, reestruturamos todo o pipeline de dados de pré-treinamento de texto, produzindo um grande volume de dados intercalados e incorporando-os ao treinamento do modelo.
Tarefas do Mundo Real
Em nossos testes e usos internos do M3, diversas tarefas do mundo real causaram uma forte impressão.
Reprodução de jornal independente
Como três capacidades essenciais para um modelo de vanguarda, queríamos ver como um contexto ultralongo de 1 milhão de palavras, recursos de codificação e agentes de alto nível e capacidade multimodal nativa se comportariam quando reunidos em uma longa sequência para resolver uma tarefa complexa.
Entregamos ao M3 um artigo premiado com o Outstanding Paper Award no ICLR 2025, intitulado ” Learning Dynamics of LLM Finetuning” , e solicitamos que ele o reproduzisse de forma independente. O artigo estuda a “dinâmica de aprendizado” de grandes modelos de linguagem durante o ajuste fino. Ao final, o M3 funcionou de forma autônoma por quase 12 horas, produzindo 18 commits e 23 figuras experimentais ao longo do processo, e concluiu com sucesso os experimentos principais.
O modelo não apenas reproduziu com sucesso a tendência de mudanças na probabilidade de previsão durante o estágio SFT, como também observou claramente o efeito de compressão destacado nos experimentos DPO, verificando com êxito o método de mitigação Extend proposto no artigo original.
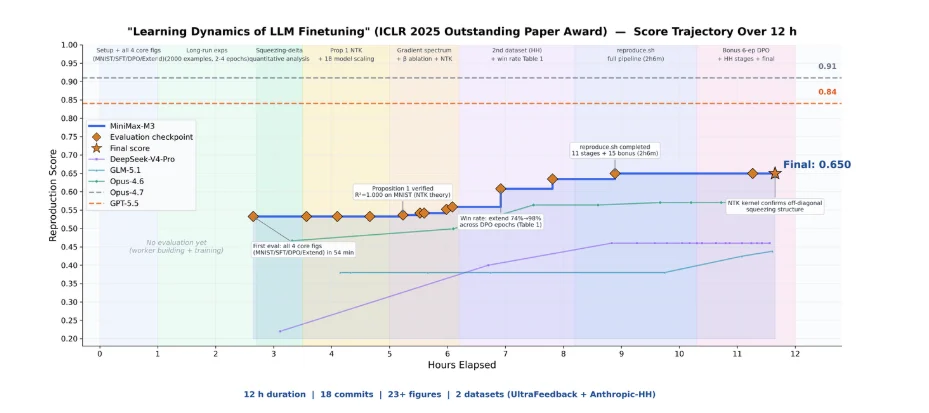
Foram necessárias capacidades multimodais para compreender as curvas, os dados e as fórmulas do artigo, enquanto o contexto extenso garantiu que o artigo, o código e os registros experimentais coubessem simultaneamente na janela de contexto. Somente com recursos de codificação e de agente suficientemente robustos, o modelo conseguiu completar a reprodução ao longo de um longo período, mesmo com execução simultânea.
O M3 era capaz de fazer tudo.
Otimização de Kernel CUDA
A multiplicação de matrizes FP8 (GEMM) é uma das partes mais intensivas em computação na inferência de modelos complexos, e também uma das mais difíceis de otimizar. Os engenheiros precisam lidar simultaneamente com múltiplas questões intimamente relacionadas, incluindo o layout dos dados, o agendamento do pipeline de computação e a adaptação às características do hardware. Em GPUs com arquitetura NVIDIA Hopper, escrever manualmente um kernel GEMM FP8 de nível de produção normalmente requer de uma a duas semanas de trabalho concentrado de uma equipe experiente.
Utilizamos essa tarefa para avaliar a capacidade de iteração autônoma de longo prazo do M3. Solicitamos ao MiniMax M3 que otimizasse esse kernel em GPUs com arquitetura NVIDIA Hopper. O modelo começou apenas com uma descrição da tarefa, um script de avaliação de benchmark e um esqueleto Triton que não podia ser executado diretamente, sem nenhuma implementação de referência de alto desempenho disponível. Isso significava que o modelo não podia tomar atalhos imitando uma solução existente; ele tinha que partir dos princípios básicos e explorar autonomamente o caminho de otimização.
Ao longo das aproximadamente 24 horas seguintes de execução contínua, o M3 concluiu 147 submissões de benchmarks e 1.959 chamadas de ferramentas. Ele percorreu de forma independente todo o processo, desde a implementação básica até a otimização para nível de produção, incluindo implementação básica, geração de configuração de autotune, diagnóstico de gargalos de desempenho, integração do CUDA Graph, reescrita persistente do kernel e otimização do escalonamento no host. Cada etapa foi autovalidada por meio do feedback dos benchmarks, sem necessidade de intervenção humana.
Por fim, após seis rodadas marcantes de otimização, o M3 melhorou a utilização máxima do hardware do Hopper FP8 de 7,6% na primeira versão para 71,3%, alcançando um aumento de velocidade de 9,4 vezes em comparação com a versão original.
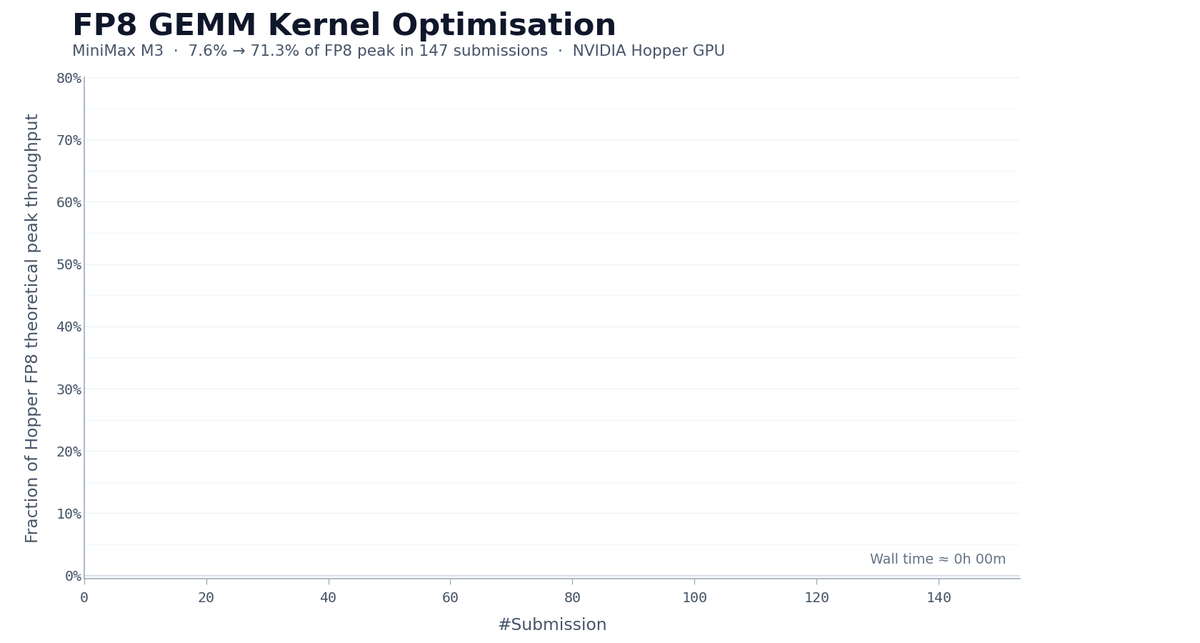
Além das métricas, o processo de execução do modelo também merece destaque. Com exceção do Opus 4.7 e do M3, a maioria dos outros modelos parou de apresentar novos progressos nas primeiras 30 submissões e encerrou suas atividades automaticamente. A melhor solução do M3, no entanto, surgiu em sua 145ª submissão. Antes disso, o modelo passou por vários platôs de desempenho, nos quais nenhuma melhoria adicional foi observada, embora tenha continuado a explorar diferentes direções de otimização.
As capacidades exigidas aqui vão além da geração de código tradicional. O contexto produzido por chamadas repetidas de ferramentas é altamente estruturado e denso, e é aqui que o mecanismo de alocação de atenção de contexto longo do MSA desempenhou um papel importante.
Permitindo que os modelos de trens M3
Na tarefa de otimização do operador CUDA, o M3 demonstrou sua capacidade de iteração de longo prazo em uma única tarefa de engenharia com um objetivo de otimização claro e sinais de feedback bem definidos. Mas o trabalho de pesquisa real geralmente não possui uma estrutura de feedback tão clara; os pesquisadores normalmente se deparam com problemas mais abertos.
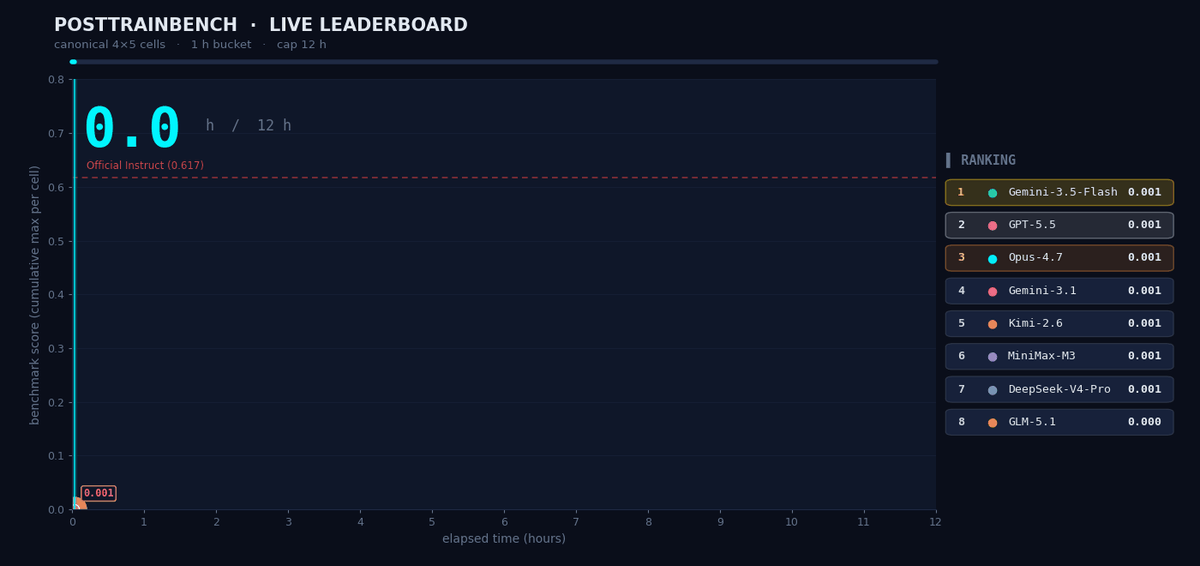
Queríamos entender o desempenho do M3 em cenários que exigem tomada de decisão autônoma, então o testamos no PostTrainBench. A tarefa era a seguinte: fornecer ao M3 quatro modelos Base que haviam concluído apenas o pré-treinamento e ainda não possuíam nenhuma capacidade subsequente, e fazer com que ele concluísse autonomamente todo o processo de síntese de dados, treinamento, avaliação e iteração em 12 horas. O objetivo final era permitir que esses modelos adquirissem capacidades básicas em raciocínio matemático (AIME2025), chamada de ferramentas (BFCL), raciocínio de conhecimento científico (GPQA Main), raciocínio aritmético básico (GSM8K) e geração de código (HumanEval).
Todo o processo de “síntese de dados → treinamento → avaliação → iteração” ocorreu sem qualquer intervenção humana. O agente teve que decidir por conta própria que tipo de dados sintetizar, qual estratégia de treinamento escolher e como ajustar a próxima rodada de planos com base nos resultados da avaliação. O M3 obteve uma pontuação final de 0,37, ligeiramente abaixo do Opus 4.7 (0,42) e do GPT-5.5 (0,39), mas claramente à frente dos outros modelos.
Código MiniMax
Com o lançamento do M3, o MiniMax Code também foi atualizado. Como um agente desenvolvido especificamente para o M3 e treinado em conjunto com ele, o MiniMax Code pode aproveitar ao máximo os recursos do M3 em contextos longos, tarefas de codificação/agentes e multimodalidade nativa, tornando-se o agente ideal para ser usado com o MiniMax-M3.
Para tarefas complexas de longo prazo, a Equipe de Agentes do MiniMax Code pode dividir grandes tarefas em fluxos de trabalho multiestágios, simultâneos e dinamicamente ajustáveis, que são então avançados colaborativamente por um cluster de agentes. Através de um circuito de controle adversarial Produtor + Verificador, a Equipe de Agentes pode produzir, refletir e corrigir continuamente durante a execução. Ela pode funcionar de forma autônoma por dias sem intervenção humana e, em última análise, entregar resultados de alta qualidade.
Observamos que a Claude Code também lançou recentemente o Dynamic Workflows em uma direção semelhante. Em comparação com a maior ênfase da Claude Code na orquestração fixa baseada em código JS, a MiniMax Code se concentra mais em “reflexão profunda e correção contínua de erros”: o agente ajusta seus planos e prioridades em tempo real com base no progresso da tarefa, enquanto os usuários podem intervir a qualquer momento para adicionar requisitos ou corrigir a direção.
Graças aos recursos multimodais nativos do M3, o MiniMax Code também oferece suporte ao uso em computadores. Por exemplo, um usuário pode dizer em seu telefone: “Ajude-me a abrir o cliente ERP local e inserir em lote as informações da fatura com base nesta planilha do Excel”. O MiniMax Code concluirá automaticamente as operações necessárias no computador, abrangendo aplicativos, arquivos e sistemas.
O MiniMax Code foi desenvolvido com base em uma estrutura que utiliza os excelentes projetos de código aberto OpenCode e Raspberry Pi. Planejamos também disponibilizar o código-fonte deste projeto no futuro, como forma de retribuir à comunidade de código aberto.
Aplicativo MiniMax Code para desktop: agent.minimaxi.com/download
O código MiniMax pode ser usado com os planos de tokens MiniMax.
Plano de Tokens MiniMax: Levando Modelos de Vanguarda para o Trabalho Diário dos Desenvolvedores
O MiniMax M3 é um modelo inovador projetado para atender a um número maior de usuários.
Com este lançamento, o Plano de Tokens MiniMax também foi atualizado em três níveis:
- Mais US$ 20/mês: aproximadamente 1,7 bilhão de tokens/mês de uso do M3
- Máximo de US$ 50/mês: ~5,1 bilhões de tokens/mês de uso do M3
- Plano Ultra: US$ 120/mês: aproximadamente 9,8 bilhões de tokens por mês de uso do M3.
Entre os planos de assinatura com preços comparáveis, o Plano MiniMax Token oferece uma das maiores cotas de tokens do mundo. Texto, imagem, voz e música compartilham o mesmo conjunto de tokens.
API
A API M3 já está disponível.
O preço depende do tamanho da entrada: chamadas com ≤512K tokens de entrada são cobradas à taxa padrão, que cobre a grande maioria dos cenários de conversação e codificação, enquanto chamadas acima de 512K são cobradas a uma taxa mais alta para contextos longos, destinada principalmente a cenários de alta carga, como análise de documentos extremamente longos e compreensão de código de repositório completo.
O M3 permite ativar ou desativar o recurso de “pensamento”. Com o “pensamento” ativado, o modelo é adequado para raciocínio complexo, tarefas com agentes e colaboração de longo prazo; com ele desativado, a resposta é mais rápida, sendo ideal para cenários sensíveis à latência, como conversas e preenchimento automático de código. Os dois modos têm o mesmo preço e podem ser alternados conforme a necessidade, no momento da solicitação.
Todos os preços podem ser combinados com dois níveis de serviço: o standardnível padrão é adequado para solicitações regulares; o prioritynível (service_tier=priority) recebe prioridade de agendamento e latência de resposta mais estável em cenários de alta concorrência, tornando-o adequado para casos de uso industrial sensíveis a SLAs. O canal prioritário está atualmente habilitado por meio do suporte de vendas e deverá ser aberto a todos os usuários em alguns dias.
Metodologia de avaliação
Verificado pelo SWE-Bench: Testado em infraestrutura interna usando o Claude Code como estrutura. Ao usar o Claude Code, o prompt padrão do sistema foi substituído. Cada teste foi executado 4 vezes e a média foi calculada.
SWE-Bench Pro: Testado em infraestrutura interna usando Claude Code como estrutura. A lógica de teste está alinhada com a avaliação oficial.
Terminal-bench 2.1: Avaliado em infraestrutura interna com um ambiente de teste configurado como 8C16G, tempo limite de 2 horas e número máximo de tokens de saída definido para 128 mil, usando o Terminus 2 como base. As pontuações para GPT-5.5, Gemini 3.1 Pro e Claude Opus 4.7 foram obtidas do ranking oficial do Terminal-bench 2.1; todos os outros modelos foram testados via API oficial na mesma infraestrutura.
Perguntas e Respostas sobre o Código-Fonte do Atlas SWE: Avaliado em infraestrutura interna com um ambiente de teste configurado como 4C8G e um tempo limite de 3 horas. As pontuações para Claude Sonnet 4.6, GPT-5.5 e Gemini 3.1 Pro foram obtidas em labs.scale.com. Claude Opus 4.7, MiniMax-M2.7 e MiniMax-M3 utilizaram o Mini-SWE-Agent como estrutura, com a lógica de avaliação alinhada ao método oficial.
NL2Repo: As pontuações para DeepSeek-V4-pro, Kimi-k2.6 e GLM-5.1 foram obtidas dehttps://qwen.ai/blog?id=qwen3.7Outros modelos foram avaliados em infraestrutura interna com um ambiente de teste configurado como 1C2G e um tempo limite de 4 horas. Claude Opus 4.7, MiniMax-M2.7, MiniMax-M3 e Gemini 3.1 Pro utilizaram o scaffolding do Claude Code; o GPT-5.5 utilizou o scaffolding do Codex. Para evitar possíveis “truques” no modelo, as seguintes modificações foram feitas com base na lógica de avaliação oficial: (1) os prompts incluíam restrições que proibiam o modelo de usar informações externas via `$_` git clone, pip install`$_`, etc.; (2) no nível do scaffolding, os comandos Bash executados pelo modelo e monitorados pelo sistema foram analisados em busca de possíveis trapaças. Os comandos identificados como trapaça foram interceptados e o modelo foi avisado para concluir a tarefa dentro do ambiente restrito.
Teste de Escrita do Atlas SWE: As pontuações para GPT-5.5, Claude Sonnet 4.6 e Gemini 3.1 Pro são do labs.scale.com. Claude Opus 4.7, MiniMax-M2.7 e MiniMax-M3 foram avaliados em infraestrutura interna usando o scaffolding de código Claude com um ambiente de teste de 4C8G e um tempo limite de 3 horas, alinhado com a lógica oficial, executado 4 vezes e com a média calculada.
Eficiência de software: avaliada em infraestrutura interna usando o conjunto de dados e o fluxo de trabalho de código aberto de eficiência de software. Ambiente de teste: 1C2G, tempo limite: 2 horas. Código Claude usado como base; as pontuações são de testes internos.
LiveSQLBench: Avaliado em infraestrutura interna usando o conjunto de dados de código aberto LiveSQLBench-Base-Full v1 (600 perguntas / 22 bancos de dados PostgreSQL) e o fluxo de trabalho oficial. O código Claude foi usado como estrutura, com prompts de descrição da tarefa substituindo os prompts padrão do sistema. Cada pergunta foi executada em um ambiente de teste dedicado com PostgreSQL pré-instalado, com tempo limite de 25 minutos. Resultados de testes internos.
VIBE-V2: Benchmark interno que abrange projetos web/Android/iOS, tanto front-end quanto full-stack, com o seguinte tipo de tarefa: desenvolvimento do zero. O Claude Code é usado como estrutura, com o paradigma Agente-como-Verificador para verificação automatizada da lógica de interação do programa e da saída visual. As pontuações são calculadas por meio de um pipeline unificado que inclui conjunto de requisitos, implantação em contêineres e ambiente de interação dinâmico, com média de 3 execuções.
SVG-Bench: Benchmark interno, tipos de entrada: texto e imagens, tarefas: criar do zero ou editar com base em recursos existentes. Claude Code usado como estrutura básica, VLM usado para verificar a precisão da renderização, média de 3 execuções.
CL-bench: Avaliado em infraestrutura interna usando dados e critérios de avaliação de código aberto do CL-bench. Configuração de avaliação totalmente alinhada com o procedimento oficial. Pontuações de testes internos.
PostTrainBench: Avaliado no código Claude usando o mecanismo Ralph-Loop por 12 horas, testando 4 modelos base em 5 benchmarks que não exigem LLM-As-Judge (AIME2025, BFCL, GPQA Main, GSM8K, HumanEval).
Kernelbench-Hard: Avaliado no código Claude em GPUs NVIDIA com arquitetura Blackwell e capacidade CUDA sm_120. Pontuação por questão = TFLOPs do operador submetido pelo agente em relação ao pico teórico do hardware atual; pontuação do benchmark = média de 9 questões.
PaperBench: Avaliado no código Claude usando o mecanismo Ralph-Loop por 12 horas. Conjunto de dados: 19 artigos reproduzíveis sem API externa. Rubricas: rubricas oficiais de código aberto de especialistas humanos. Modelo de pontuação: Opus-4.6.
Rubricas do GDPval: Avaliação interna utilizando casos do conjunto de dados público do GDPval, pontuação pontual baseada em rubricas públicas, ambiente alinhado com o andaime do GDPval-AA.
BrowseComp: Utiliza a mesma estrutura de agentes que o WebExplorer (Liu et al., 2025). Quando o uso de tokens excede 64 mil, todo o histórico é descartado.
DRACO: Resultados do MiniMax M3 avaliados usando o suporte interno (acessível através da habilidade Deep Research no código do MiniMax). A pontuação é baseada em rubricas oficiais para cada questão, sendo a pontuação final a média de todas as questões. Modelo de pontuação: Claude Opus 4.6. Os resultados do Claude Opus 4.7 foram obtidos do cartão do modelo Opus 4.7.
BankerToolBench: Testado no conjunto de dados público BankerToolBench. Todos os modelos, exceto o GPT-5.5, utilizaram o scaffolding do Claude Code; o GPT-5.5 utilizou o Codex. A pontuação foi baseada nos critérios do conjunto de dados, utilizando o MiniMax M2.7 como modelo de pontuação.
OfficeQA Pro: Para simular cenários realistas, os arquivos relevantes foram fornecidos como um sistema de arquivos para o modelo, avaliados usando o método de scaffolding do Claude Code. A pontuação exigia correspondência exata com as respostas.
SpreadSheetBench-v1: Avaliado em conjunto de dados público usando o scaffolding do Claude Code.
YC-Bench: Avaliado usando o código-fonte e a configuração oficiais do YC-Bench, com o ambiente alinhado à configuração oficial. Métrica: ativos finais (fundos).
LOCA-Bench (256k): Avaliado usando o código-fonte oficial do LOCA-bench, modo React oficial, Comprimento da Descrição do Ambiente = 256k.
MCP Atlas: Avaliado usando o código-fonte oficial do MCP Atlas. Pontuações do conjunto público usando o Gemini 2.5 Pro como modelo de pontuação, alinhado com o modelo oficial.
Apex-Agents: Utiliza a base de código Archipelago, o framework ReAct Toolbelt e o modelo de pontuação Claude Sonnet 4.6.
Claw-Eval: Avaliado usando o código-fonte oficial do Claw-Eval, Grupo de Tarefas Gerais (161 tarefas), modelo de pontuação Gemini 3.0 Flash, alinhado com o modelo oficial. Métrica: Pontuação Pass³.
Verificado pela OSWorld: Testado em 361 amostras da coleção nogdrive usando o código-fonte oficial verificado pela OSWorld (o script de teste será disponibilizado em breve como código aberto). O M3 usa coordenadas relativas de 0 a 1000, resolução de imagem de 1920×1080 e número máximo de passos (Max Steps) = 200. Aumentar o número máximo de passos de 100 para 200 melhorou a taxa de conclusão da tarefa de 68,70% para 70,06%.
OmniDocBench: Largura máxima da imagem = 3584 pixels, usando o conjunto de dados público OmniDocBench v1.5 e a lógica de avaliação oficial. Foram adicionadas restrições de formatação razoáveis além das instruções oficiais. Gemini 3.1 Pro, GPT-5.5 e Claude Opus 4.7 utilizaram os parâmetros de API padrão.
MMMU Pro: Alinhado com a avaliação oficial. O prompt impõe restrição de formato na última linha do modelo para facilitar a análise.
VideoMMMU: Taxa de quadros de vídeo = 1 FPS, máximo de 512 quadros, aresta longa de um único quadro de 672 a 1008 pixels. Prompt oficial do VideoMMMU utilizado, pontuação LLM-as-a-Judge. MiniMax M3: tokens de saída máximos = 32 mil, temperatura = 1,0, top_p = 0,95. Modelos externos: tokens de saída máximos = 64 mil, temperatura = 0,7, top_p = 0,95, modo de pensamento mais avançado.
Video-MME: Taxa de quadros de vídeo = 1 FPS, máximo de 1024 quadros (*limite da API externa de 640 quadros; MiniMax M3 obteve 84,6 pontos com 512 quadros), borda longa de um único quadro de 336 a 672 pixels, legendas inseridas a cada 30 segundos intercaladas nos quadros. Prompt oficial do Video-MME utilizado, pontuação do LLM como Juiz. MiniMax M3: tokens de saída máximos = 16 mil, temperatura = 1,0, top_p = 0,95. Modelos externos: tokens de saída máximos = 64 mil, temperatura = 0,7, top_p = 0,95, modo de pensamento mais avançado. *Observação: Taxa de erro da API Claude Opus 4.7 >20%, resultados não relatados.
IMO 2025 e USAMO 2026: Alinhados com a avaliação oficial do MathArena. Cada competição: 6 problemas, pontuação máxima 42. Saída da prova do modelo: (1) Normalização da solução → (2) modelos robustos duplos avaliados usando rubricas de especialistas humanos (GPT-5.4 com alto esforço de raciocínio, Gemini 3.1 Pro com alto esforço de raciocínio) → (3) os dois juízes consideram a pontuação mínima como a pontuação final. Avaliação M3: 512 mil tokens de saída máximos, temperatura = 1,0, estrutura de escalonamento de tempo de teste com até 10 iterações. Outras métricas de modelo de código fechado: resultados médios em k iterações