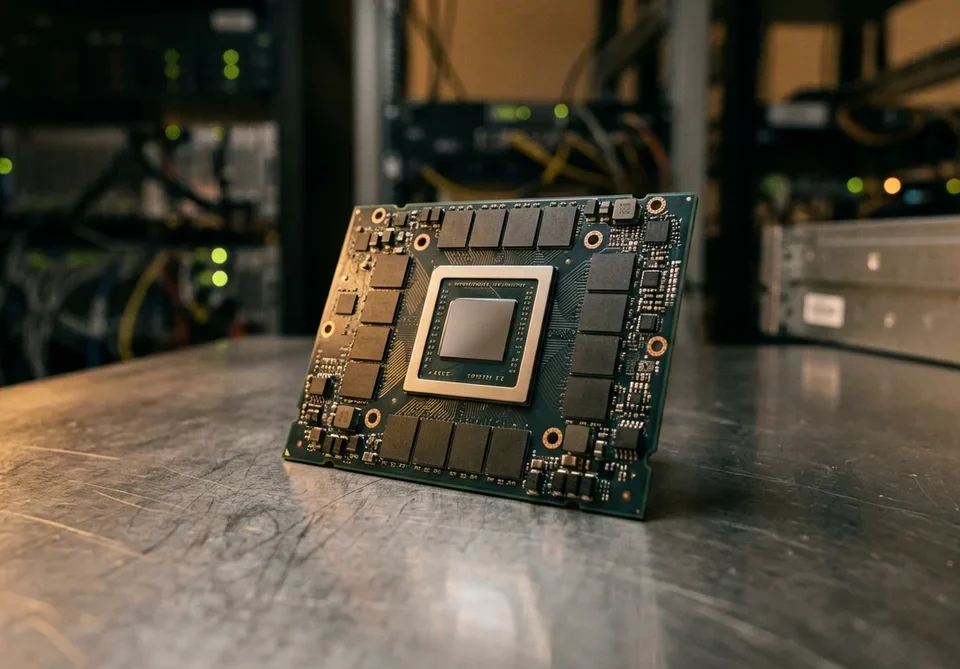
A AMD e a Microsoft oficializaram nesta segunda a expansão de uma parceria estratégica que agora cobre toda a pilha de hardware de IA no Azure — GPUs, CPUs, rede e software. No centro do anúncio está o Helios Rackscale Solution, uma plataforma integrada que combina as GPUs AMD Instinct MI455X, os processadores AMD EPYC "Venice" de 6ª geração, a linha de DPUs Pensando e o stack de software ROCm (o ecossistema aberto da AMD para programar GPUs, equivalente ao CUDA da Nvidia). A Microsoft será uma das primeiras a colocar o sistema em produção em larga escala na nuvem.
O que é o Helios e por que ele importa
Helios não é um chip isolado — é um rack completo projetado para treinar e servir modelos de IA em escala industrial. A ideia é entregar, num único pacote, tudo o que uma operação de inferência (o processo de rodar um modelo já treinado para gerar respostas em tempo real) precisa: poder de processamento bruto, alta largura de banda entre aceleradores e rede de baixa latência para conectar milhares de racks.
A aposta da AMD é que o mercado está cansado de depender de um único fornecedor. Ao entregar uma alternativa integrada — hardware + rede + software — a empresa tenta reproduzir, em chave aberta, o modelo que a Nvidia construiu com o NVL72 e o GB200. O ROCm, durante anos visto como o calcanhar de Aquiles da AMD, aparece aqui como peça central da estratégia.
No Azure, o Helios será usado especificamente para inferência de frontier models — os modelos de IA mais pesados e mais capazes disponíveis, geralmente operados por grandes laboratórios e hyperscalers. Isso inclui os próprios modelos da Microsoft, os serviços do Azure AI Foundry e aplicações de clientes corporativos que precisam servir LLMs em produção.
CPUs Venice e novas VMs para workloads agentic
Além das GPUs, o acordo prevê duas novas famílias de máquinas virtuais no Azure rodando processadores EPYC "Venice", a 6ª geração da linha de servidores da AMD:
- Azure HDv2: voltada para agentic AI (sistemas de IA que executam cadeias longas de tarefas de forma autônoma, tomando decisões a cada passo) e pipelines de dados.
- Azure HXv2: focada em design de semicondutores, workloads de EDA (Electronic Design Automation — o software usado para projetar e validar chips) e engenharia pesada.
Essas VMs se somam ao portfólio existente de instâncias EPYC no Azure, que já cobre workloads de uso geral. A mensagem é clara: a AMD quer presença em todas as camadas em que a inferência de IA opera, do chip de treinamento ao pipeline de dados.
A camada de rede: Pensando e Azure Boost
O terceiro pilar do anúncio é a rede. A Microsoft já usa DPUs Pensando (Data Processing Units — processadores especializados que tiram das CPUs tarefas de rede, armazenamento e segurança, liberando a CPU para trabalho de aplicação) em vários serviços do Azure, e agora a integração se aprofunda com o Azure Boost, tecnologia da Microsoft que move funções de rede e armazenamento para fora das VMs e para dentro de hardware dedicado.
A combinação Pensando + Azure Boost promete reduzir a carga sobre as CPUs de propósito geral, melhorar a eficiência energética e padronizar o processamento de conexões em escala de nuvem. Em workloads agentic — onde um único pedido pode disparar dezenas ou centenas de chamadas internas ao modelo — essa camada de rede virou tão crítica quanto o FLOPS bruto das GPUs.
O que muda na prática
A AMD começará a enviar o Helios para clientes, incluindo a Microsoft, no segundo semestre de 2026. A escala da operação na Azure ainda não foi divulgada em números concretos de racks ou capacidade total, mas o próprio formato rackscale (cada rack tratado como uma unidade integrada, em vez de servidores isolados) indica que estamos falando de clusters com milhares de GPUs operando em conjunto.
Para a AMD, o movimento consolida uma narrativa que a CEO Lisa Su vem construindo há anos: a de que a empresa não compete mais apenas em preço ou em benchmark pontual, mas em solução full-stack. Para a Microsoft, é diversificação de fornecedores em um momento em que a demanda por inferência de IA está crescendo mais rápido do que a capacidade de qualquer fornecedor individual.
O que ainda não sabemos
O comunicado não traz números de capacidade, preço por token ou regiões do Azure onde o Helios será implantado primeiro. Também não há detalhe sobre quais modelos específicos da Microsoft rodarão优先 na infraestrutura AMD — a empresa falou genericamente em "frontier models" e serviços Azure AI. A comparação direta de desempenho e custo por inferência contra instâncias baseadas em Nvidia continua sendo a métrica que o mercado vai querer ver.
A AMD entra em 2026 com a aposta mais agressiva da sua história no segmento de IA em nuvem. Se o Helios entregar o que promete em produção real, a dinâmica do mercado de infraestrutura para IA pode mudar mais rápido do que muitos ожидают.
Fontes consultadas: AMD Newsroom — Microsoft to Deploy Next-Gen AMD Instinct and AMD EPYC Processors